Unicode Attack چیست؟

آشنایی با Unicode Attack؛ چگونه امنیت برنامه‌ها را تهدید می‌کند؟ 

Unicode Attack به مجموعه‌ای از تکنیک‌های حمله گفته می‌شود که از تفاوت در نمایش، Encoding، Normalization، Validation یا Parsing کاراکترهای Unicode سوءاستفاده می‌کنند تا یک ورودی در یک بخش از سیستم امن به نظر برسد، اما در بخش دیگری به شکل متفاوتی تفسیر شود.

این تفاوت می‌تواند در برخی سناریوها به WAF Bypass، XSS، RCE، Authentication Bypass یا جعل هویت متنی منجر شود.

در Black Hat USA 2026 نیز Research با عنوان Beyond Normalization: The Expanding Unicode Attack Surface دقیقاً به همین مسئله پرداخته است: وقتی WAF، Framework، Database و سایر اجزای یک زنجیره، یک ورودی Unicode را یکسان تفسیر نمی‌کنند، مهاجم می‌تواند از این شکاف برای عبور از کنترل‌های امنیتی استفاده کند.

Unicode چیست؟

Unicode یک استاندارد جهانی برای نمایش و پردازش متن است که به سیستم‌ها اجازه می‌دهد مجموعه بسیار بزرگی از کاراکترهای زبان‌ها و سیستم‌های نوشتاری مختلف را به‌صورت استاندارد مدیریت کنند.

هر کاراکتر Unicode یک Code Point دارد که اغلب با قالبی مانند U+XXXX نمایش داده می‌شود.

برای مثال:

  • A → U+0041
  • a → U+0061
  • é → U+00E9

اما Unicode با UTF-8 یکی نیست.

Unicode مشخص می‌کند یک کاراکتر چیست؛ درحالی‌که UTF-8 یکی از روش‌های Encoding آن کاراکترها به بایت است.

این تفاوت برای امنیت اهمیت زیادی دارد، چون ممکن است یک سیستم در سطح بایت تصمیم بگیرد و سیستم دیگری همان داده را پس از Decode یا Normalization به‌عنوان متن پردازش کند.

RFC 3629 نیز صراحتاً هشدار می‌دهد که Decoderهای UTF-8 باید در برابر Sequenceهای نامعتبر محافظت شوند، زیرا تفسیر نادرست آن‌ها می‌تواند پیامدهای امنیتی داشته باشد.

Unicode Attack چگونه اتفاق می‌افتد؟

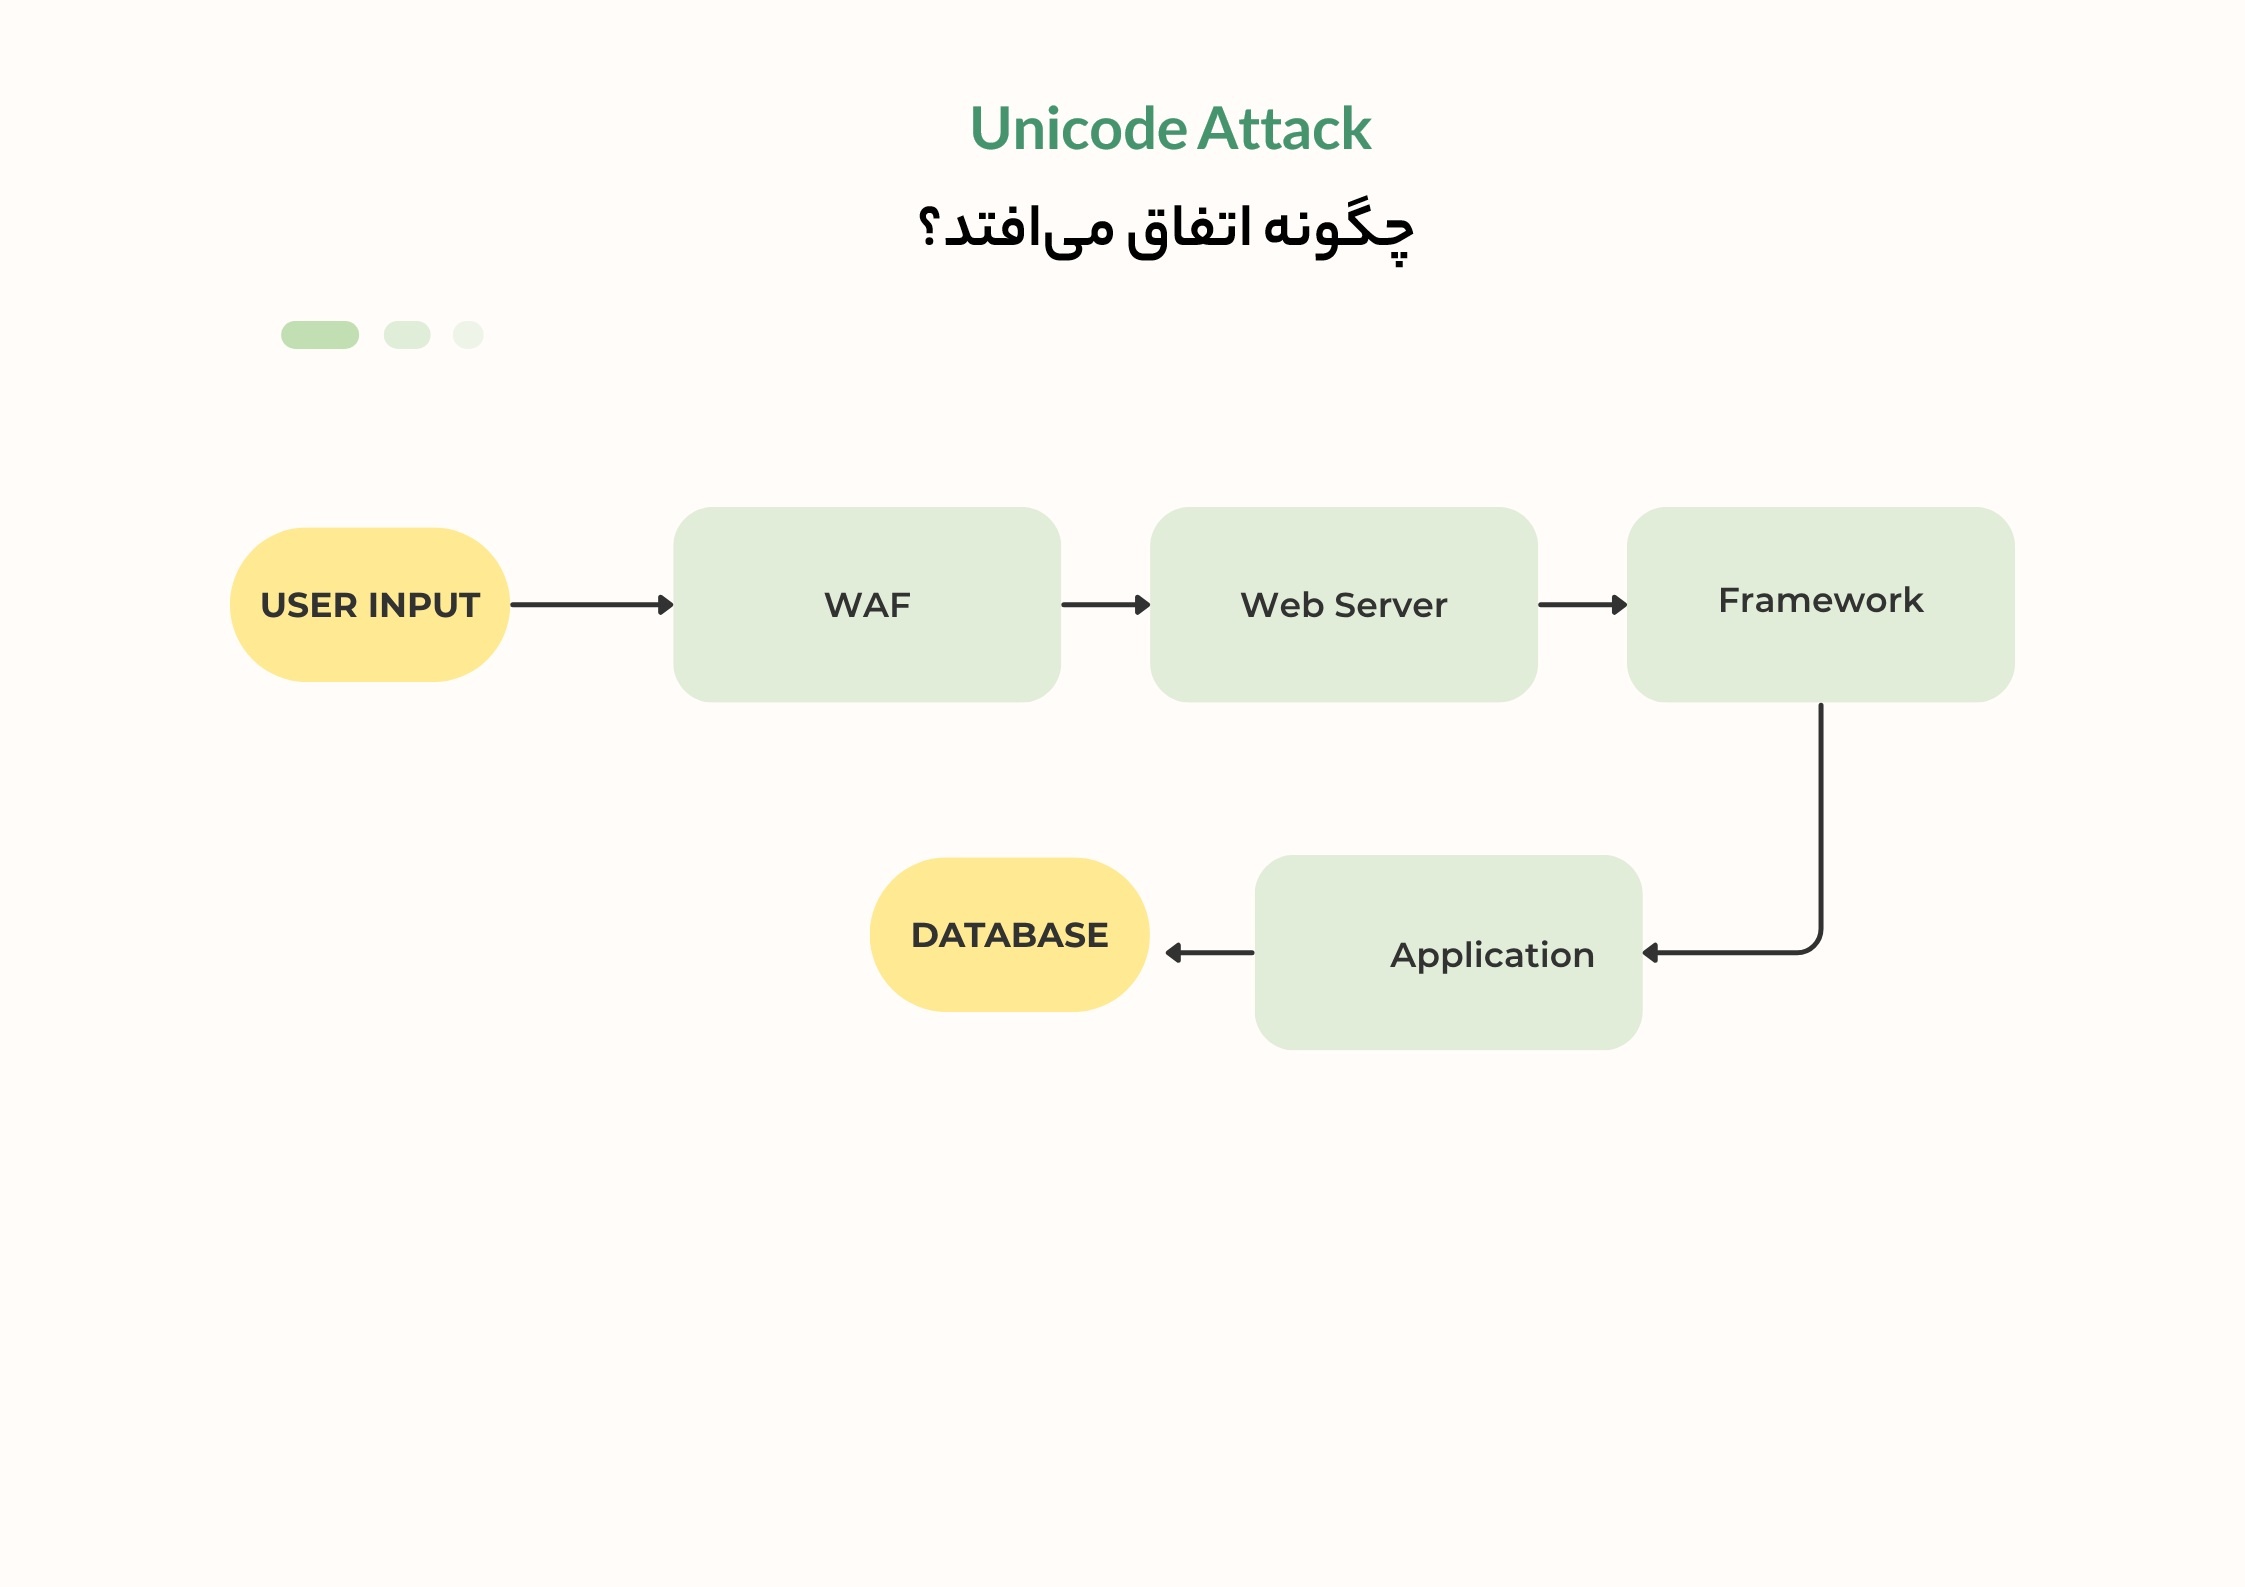
برای درک موضوع و مراحل Unicode Attack، تصور کنید یک درخواست وب از چند مرحله عبور می‌کند:

Unicode Attack چگونه اتفاق می افتد؟
حالا فرض کنید WAF ورودی را با یک روش Decode و Normalize بررسی کند، اما Application همان ورودی را با روش دیگری تفسیر کند. ممکن است:

WAF بگوید: امن است.
اما
Application بگوید: این یک ورودی مخرب است.

این همان ایده‌ای است که در بسیاری از حملات مبتنی بر Parsing Discrepancy دیده می‌شود. در Research سال ۲۰۲۶ نیز همین مسئله در زمینه Unicode بررسی شده‌است؛ یعنی تفاوت در فرض‌های لایه‌های مختلف درباره معتبر بودن یا معنای یک کاراکتر می‌تواند باعث شکست Security Boundary شود.


در رسیس بیشتر بخوانید

منظور از Web Security و Website Security چیست؟


Unicode Normalization چیست؟

یکی از مهم‌ترین مفاهیم برای فهم Unicode Attack، بحث Normalization است. گاهی یک متن واحد می‌تواند با Sequenceهای متفاوتی از Code Pointها نمایش داده شود.

برای مثال، حرف:

é

می‌تواند به‌صورت یک Code Point مستقل یعنی U+00E9 ذخیره شود یا به شکل ترکیبی از:

e + ◌́

نمایش داده شود.

از نظر کاربر، هر دو یک چیز هستند؛ اما از نظر Binary Representation الزاماً یکسان نیستند. Unicode برای حل این مشکل چهار Normalization Form تعریف می‌کند:

Form

مفهوم

NFC

Canonical Decomposition + Composition

NFD

Canonical Decomposition

NFKC

Compatibility Decomposition + Composition

NFKD

Compatibility Decomposition

هدف Normalization این است که رشته‌های معادل، در یک فرم مشخص به نمایش یکسان یا قابل مقایسه برسند. اما یک نکته مهم وجود دارد:

Normalization به‌تنهایی یک راهکار امنیتی نیست.

نوع Normalization باید متناسب با کاربرد انتخاب شود. Unicode حتی هشدار می‌دهد که NFKC و NFKD نباید بدون توجه به کاربرد روی متن دلخواه اعمال شوند، چون می‌توانند برخی تمایزهای معنایی یا قالب‌بندی را حذف کنند.

چرا تفاوت در Normalization می‌تواند خطرناک باشد؟

فرض کنید یک سیستم قبل از بررسی امنیتی، ورودی را Normalize نکند:

  • Input
  • WAF
  • Application

WAF ممکن است یک رشته را به شکل خاصی ببیند، اما Application بعداً آن را Normalize کند و به شکل دیگری تبدیل شود. حالا یک مهاجم می‌تواند به‌جای ارسال مستقیم الگوی مخرب، ورودی‌ای ارسال کند که:

قبل از Normalization بی‌خطر به نظر برسد.

اما:

بعد از Normalization معنای متفاوتی پیدا کند.

اگر کنترل امنیتی قبل از این تبدیل انجام شود و پردازش واقعی بعد از آن، یک Interpretation Gap ایجاد می‌شود. این Gap می‌تواند همان نقطه‌ای باشد که مهاجم برای عبور از Security Control به آن نیاز دارد.

حملات Unicode چه انواعی دارند؟

Unicode Attack یک تکنیک واحد نیست؛ بلکه یک خانواده از مشکلات و تکنیک‌هاست. مهم‌ترین آن‌ها عبارت‌اند از:

۱. Unicode Confusables

برخی کاراکترها از نظر ظاهری بسیار شبیه یکدیگر هستند، اما Code Point متفاوتی دارند. برای مثال، در Unicode Security Mechanisms، نمونه‌ای مانند:

paypal

و نسخه‌ای که در آن برخی حروف با کاراکترهای مشابه از Script دیگری جایگزین شده‌اند، به‌عنوان Confusable بررسی می‌شود. این موضوع می‌تواند برای:

  • Phishing
  • جعل دامنه
  • جعل Username
  • Impersonation
  • Social Engineering

مورد سوءاستفاده قرار گیرد. Unicode برای شناسایی چنین مواردی مکانیزم‌هایی مانند Mixed-Script Detection و Confusable Detection تعریف کرده است.

۲. Invalid UTF-8

UTF-8 دارای قواعد مشخصی برای Sequenceهای معتبر است. RFC 3629 تأکید می‌کند که Decoder نباید Sequenceهای نامعتبر را به‌عنوان UTF-8 معتبر پردازش کند. زیرا ممکن استSecurity Layer یک Byte Sequence را رد کند اما Application همان Sequence را Decode کرده و معنای دیگری از آن استخراج کند.

RFC 3629 حتی نمونه‌ای از سوءاستفاده از Encoding نامعتبر برای پنهان کردن NUL و Path Traversal را مستند کرده و می‌گوید چنین خطاهایی می‌توانند پیامدهای امنیتی واقعی داشته باشند.

۳. Unicode و WAF Bypass

WAF اغلب برای شناسایی الگوهای مخرب، Request را بررسی می‌کند. اما اگر WAF یک Representation و Backend یک Representation دیگری را ببیند، ممکن است مهاجم بتواند ورودی را طوری طراحی کند که از فیلتر عبور کند.

این مسئله فقط مختص Unicode نیست؛ در ادبیات امنیت وب، Parsing Discrepancy یکی از زمینه‌های شناخته‌ شده برای WAF Evasion است.

برای نمونه، پژوهش WAFFLED در سال ۲۰۲۵ نشان داد که تفاوت در Parsing می‌تواند برای پیدا کردن Bypassهای WAF مورد استفاده قرار گیرد و ۱۲۰۷ Bypass را در پنج WAF بررسی‌ شده گزارش کرد. تحقیقات Black Hat امسال (۲۰۲۶) این مسئله را از زاویه Unicode دنبال می‌کند و نشان می‌دهد که Unicode را نمی‌توانیم صرفاً یک مسئله Encoding ساده در نظر بگیریم.

  • Unicode و XSS

در حملات Cross-Site Scripting یا XSS، مهاجم تلاش می‌کند داده‌ای وارد برنامه کند که در نهایت به‌عنوان HTML یا JavaScript تفسیر شود.

اگر Security Control یک ورودی را در یک Representation بررسی کند و Browser یا Application آن را بعداً به شکل دیگری Decode یا Normalize کند، امکان ایجاد شکاف میان آنچه WAF می‌بیند و آنچه Browser اجرا می‌کند، وجود دارد.

به همین دلیل Unicode می‌تواند در برخی زنجیره‌های حمله XSS به‌عنوان بخشی از Obfuscation یا Parsing Discrepancy وارد شود.

  • Unicode و RCE

در سناریوهای پیچیده‌تر، اگر اختلاف در Parsing به یک نقطه حساس در Application یا Backend برسد، پیامد آن می‌تواند فراتر از XSS باشد.

برای مثال، اگر ورودی پس از چند مرحله Decode و Transformation به ساختاری تبدیل شود که یک Parser یا Interpreter آن را به شکل خطرناک پردازش کند، Unicode/Encoding Confusion می‌تواند بخشی از زنجیره‌ای باشد که در نهایت به Remote Code Execution یا RCE منجر می‌شود.

نکته مهم این است که Unicode به‌تنهایی باعث RCE نمی‌شود. بلکه ممکن است به‌عنوان یک Primitive یا مرحله در Attack Chain برای عبور از یک کنترل امنیتی استفاده شود. این تفکیک برای جلوگیری از بزرگ‌نمایی موضوع بسیار مهم است.

  • Unicode و Authentication Bypass

یکی دیگر از نقاط حساس، سیستم‌هایی هستند که برای Username، Email، Domain یا سایر Identifierها از Unicode استفاده می‌کنند. اگر سیستم Registration یک Username را با یک روش Normalize کند، اما سیستم Authentication آن را با روش دیگری مقایسه کند، ممکن است دو رشته از نظر یک بخش سیستم متفاوت باشند ولی از نظر بخش دیگری یکسان تلقی شوند.

Unicode Security Standard نیز بر تعریف دقیق عملیات String Comparison، Casing و Normalization برای Identifierها تأکید می‌کند. در سیستم‌های حساس، چنین اختلافی می‌تواند زمینه‌ساز مشکلات زیر شود:

Account Confusion

  • Username Collision
  • Access-Control Errors
  • Identity Spoofing

در رسیس بیشتر بخوانید

حملات فیشینگ چیست؟


Black Hat USA 2026 چه چیز جدیدی درباره Unicode نشان داد؟

در Black Hat USA 2026، آقای Ryan Barnett و  Isabella Barnett در Briefing با عنوان Beyond Normalization: The Expanding Unicode Attack Surface به بررسی Attack Surface پرداختند.

این جلسه در Trackهای Application Security: Offense و Application Security: Defense قرار داشت. توضیح رسمی Research یک نکته کلیدی دارد:

Unicode exploitation فقط به Normalization محدود نمی‌شود.

در Applicationهای مدرن، داده ممکن است از مسیرهای متعدد زیر عبور کند:

  1. WAF Transformation
  2.  Framework Parsing
  3.  Application Logic
  4.  Database Collation
  5.  LLM Preprocessing

اگر هر کدام از این لایه‌ها درباره Validity یا Meaning یک ورودی Unicode فرض متفاوتی داشته باشند، Security Boundary ممکن است شکسته شود. بنابراین پیام اصلی این Research بلک هت ۲۰۲۶ را می‌توانیم به صورت زیر خلاصه کنیم:

مشکل فقط «Unicode» نیست؛ مشکل «تفاوت در تفسیر Unicode» است.

این موضوع همان چیزی است که Unicode را از یک موضوع Encoding ساده به یک موضوع امنیتی تبدیل می‌کند.

Unicode حتی وارد امنیت LLMها شده است

یکی از نکات جالب Research امسال بلک هت این است که زنجیره پردازش Unicode فقط به Web Application محدود نمی‌شود. امروزه ورودی ممکن است از مسیر User، Web Application، WAF، Backend و LLM عبور کند. 

اگر هر لایه یک Representation متفاوت از متن داشته باشد، مدل ممکن است چیزی متفاوت از آنچه Security Layer بررسی کرده، دریافت کند.

به همین دلیل Research Black Hat، LLM Preprocessing را نیز در زنجیره پردازش Unicode قرار می‌دهد.

این موضوع به‌خصوص با گسترش سیستم‌های AI و Agentic Applicationها اهمیت بیشتری پیدا می‌کند؛ زیرا ورودی متنی می‌تواند علاوه بر نمایش یا ذخیره‌سازی، روی تصمیم‌گیری و اجرای Action توسط مدل نیز اثر بگذارد.

چگونه از Unicode Attack جلوگیری کنیم؟

مهم‌ترین اصل این است که هر لایه نباید Unicode را به روش خودش تفسیر کند. برای کاهش ریسک، تیم‌های توسعه و امنیت باید چند اصل را رعایت کنند.

۱. UTF-8 را به‌صورت صحیح Validate کنید

ورودی باید مطابق استاندارد UTF-8 بررسی شود و Sequenceهای نامعتبر رد شوند. RFC 3629 صراحتاً توصیه می‌کند Decoderها از پردازش Sequenceهای غیر مجاز جلوگیری کنند.

۲. Parsing و Normalization را استاندارد کنید

مشخص کنید:

  • ورودی چه زمانی Decode می‌شود؟
  • چه زمانی Normalize می‌شود؟
  • از کدام Normalization Form استفاده می‌شود؟
  • Validation قبل از Normalization انجام می‌شود یا بعد از آن؟
  • WAF و Application از چه منطق یکسانی استفاده می‌کنند؟

نباید یک لایه NFC و لایه دیگر NFKC را بدون دلیل و هماهنگی استفاده کند.

۳. Security Check را با Representation واقعی هماهنگ کنید

اگر Application در نهایت داده را Decode یا Normalize می‌کند، Security Control نیز باید درک دقیقی از همان Representation داشته باشد. به زبان ساده:

چیزی که قرار است پردازش شود را همان‌طور که پردازش می‌شود، بررسی کنید.

۴. برای Identifierها Policy مشخص داشته باشید

برای:

  • Username
  • Domain
  • Email
  • API Identifier
  • Account Name

باید مشخص شود چه Scriptها و Code Pointهایی مجاز هستند. Unicode در UTS #39 مکانیزم‌هایی برای Identifier Security، Confusable Detection و Mixed-Script Detection ارائه می‌کند.

۵. روی Confusable Characters کنترل داشته باشید

در سیستم‌هایی که هویت کاربر یا برند اهمیت زیادی دارد، باید امکان شناسایی Identifierهای ظاهراً مشابه وجود داشته باشد. مثلاً  paypal و رشته‌ای که برخی حروف آن با کاراکترهای مشابه از Script دیگری ساخته شده‌اند، ممکن است از نظر بصری یکسان به نظر برسند، اما Code Pointهای متفاوتی داشته باشند.

۶. WAF را تنها خط دفاعی ندانید

WAF یک لایه مهم دفاعی است، اما نباید فرض کرد که هر ورودی‌ای که WAF قبول کرد، در Backend نیز بی‌خطر است.

به‌خصوص در برابر حملاتی که بر Parser Differential یا تفاوت Representation تکیه دارند، هماهنگی میان WAF و Application اهمیت زیادی دارد.

چک‌لیست امنیت Unicode ؛ تیم‌های امنیت و توسعه

قبل از اینکه Unicode را در یک Application نادیده بگیریم، این سؤال‌ها را بپرسیم:

سؤال

وضعیت مطلوب

آیا UTF-8 ورودی Validate می‌شود؟

بله

آیا Invalid UTF-8 رد می‌شود؟

بله

آیا Normalization مشخص است؟

بله

آیا WAF و Backend برداشت یکسانی دارند؟

بله

آیا Identifier Policy مشخص است؟

بله

آیا Mixed-Script بررسی می‌شود؟

در موارد لازم

آیا Confusable Characters بررسی می‌شوند؟

در موارد حساس

آیا Security Check روی Representation واقعی انجام می‌شود؟

بله

آیا ورودی قبل و بعد از Transformation تست می‌شود؟

بله

آیا Unicode Attack یک آسیب‌پذیری مستقل است؟

معمولاً نه، Unicode یک استاندارد ضروری برای پردازش متن است و استفاده از آن ذاتاً ناامن نیست. ریسک زمانی ایجاد می‌شود که سیستم‌ها در مورد اینکه یک رشته چیست، چگونه باید Decode شود یا چگونه باید مقایسه شود، توافق نداشته باشند.

بنابراین Unicode بیشتر از اینکه یک «آسیب‌پذیری» باشد، می‌تواند یک Attack Surface یا بخشی از یک Attack Chain باشد. این تفاوت مفهومی مهم است.

مرور پایانی مفاهیم گفته شده در مورد Unicode Attack

Unicode بخش جدایی‌ناپذیر وب، نرم‌افزار، سیستم‌عامل‌ها و سرویس‌های مدرن است. بنابراین حذف آن راهکار امنیتی نیست. مسئله اصلی، مدیریت نادرست Unicode است.

اگر یک WAF، Framework، Application، Database یا LLM ورودی یکسانی را به شکل‌های متفاوت تفسیر کند، مهاجم ممکن است بتواند از همین اختلاف برای عبور از Security Control استفاده کند.

Research Beyond Normalization: The Expanding Unicode Attack Surface در Black Hat USA 2026 نیز همین نگاه را برجسته کرده است: Attack Surface Unicode فقط به Normalization محدود نیست و باید کل زنجیره پردازش داده را در نظر گرفت.

از طرف دیگر، استانداردهای رسمی Unicode سال‌هاست درباره Confusables، Mixed-Script، Normalization و Identifier Security راهکار و توصیه ارائه می‌کنند.

پس یک اصل ساده را به خاطر بسپارید:

امنیت یک ورودی فقط به چیزی که کاربر ارسال می‌کند، بستگی ندارد؛ بلکه به چیزی بستگی دارد که هر لایه از سیستم در نهایت آن را چگونه تفسیر می‌کند.

سوالات رایج درباره Unicode Attack

Unicode Attack چیست؟

Unicode Attack به تکنیک‌ها یا حملاتی گفته می‌شود که از تفاوت در Encoding، Parsing، Normalization، Validation یا نمایش کاراکترهای Unicode برای دور زدن کنترل‌های امنیتی یا ایجاد رفتار ناخواسته سوءاستفاده می‌کنند.

خیر. Unicode یک استاندارد ضروری برای نمایش و پردازش متن است. مشکل زمانی ایجاد می‌شود که اجزای مختلف یک سیستم، یک ورودی Unicode را به شکل متفاوتی تفسیر کنند.

اگر WAF یک ورودی را با یک روش Decode یا Normalize بررسی کند اما Backend همان ورودی را متفاوت تفسیر کند، ممکن است یک Parsing Discrepancy ایجاد شود که مهاجم بتواند از آن برای Bypass کنترل‌های WAF استفاده کند.

Normalization فرآیندی است که Representationهای معادل Unicode را به فرم‌های استانداردی مانند NFC، NFD، NFKC یا NFKD تبدیل می‌کند تا مقایسه و پردازش متن قابل پیش‌بینی‌تر شود.

Unicode به‌تنهایی باعث XSS یا RCE نمی‌شود؛ اما اختلاف در Encoding، Normalization یا Parsing می‌تواند در برخی شرایط بخشی از Attack Chain برای عبور از Security Control و رسیدن به آسیب‌پذیری‌هایی مانند XSS یا RCE باشد.